C# 生成 PDF 文档:代码、HTML 与表单三条工作流怎么选
C# 生成 PDF 文档:代码、HTML 与表单三条工作流怎么选
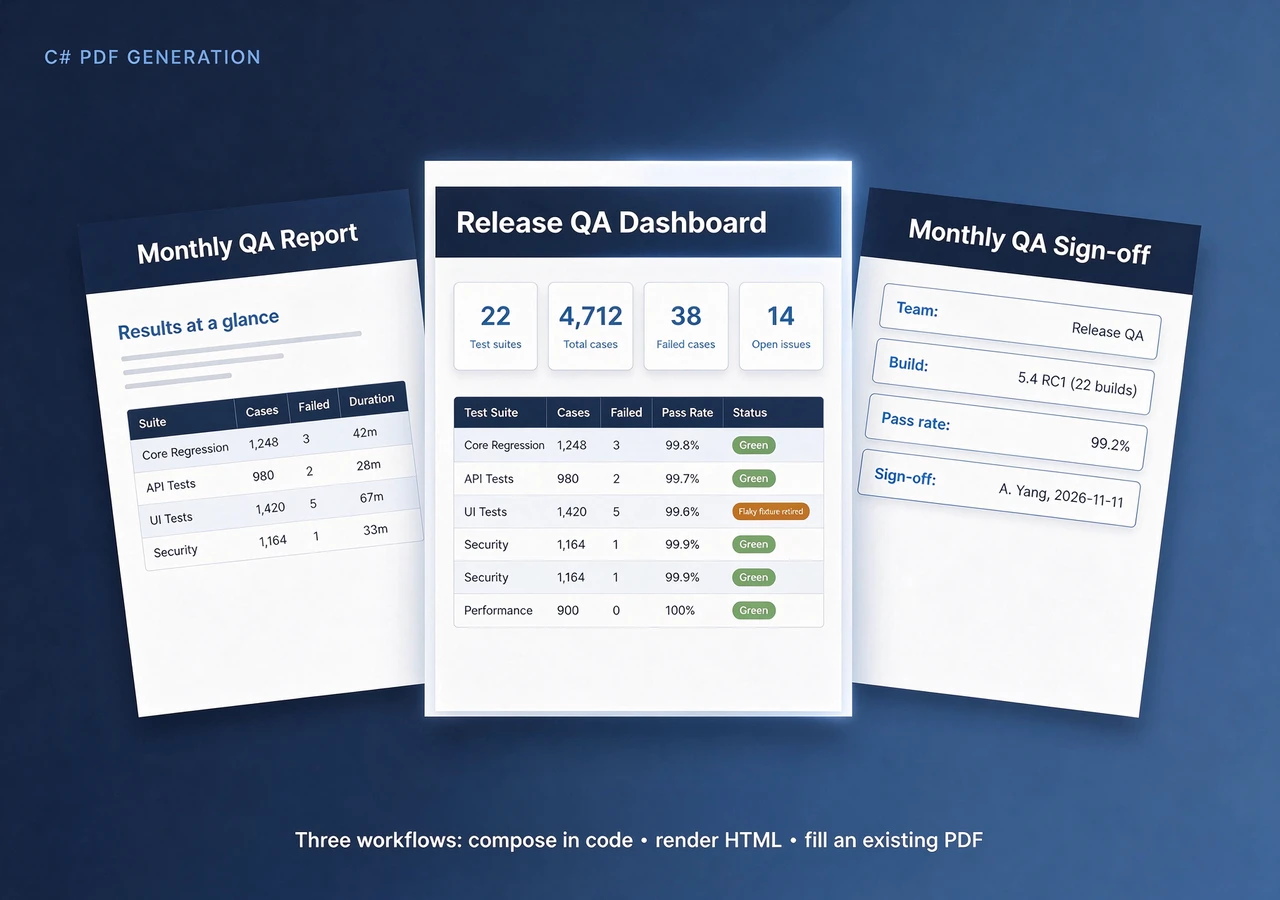
在 C# 里生成一份 PDF 文档,起点决定了走哪条路:手里是程序自己的数据,用排版 API 画页面;手里是网页或 HTML 模板,交给渲染引擎输出;手里是一份已经做好版式的 PDF,往它的字段或占位文本里填值。三条路在布局控制、分页方式和部署依赖上差别很大,选错路后面维护成本会一直拖着走。
本文按”输入材料”分类这三条工作流,并给出每条在 Spire.PDF for .NET 上的实测结果。全部结论基于 Spire.PDF for .NET 12.11.0(2026 年 11 月发布,Windows 11、.NET 10 控制台程序实测),包括哪些步骤容易出错。需要说明,Spire.PDF 是 E-iceblue 的产品,本文由 E-iceblue 发布,测试也由发布方完成。
快速导航
1. 先看手里有什么
按运行时手里的材料对号入座,比按库的名字挑更直接:
| 类别 | 运行时输入 | 工作流 |
|---|---|---|
| 生成新 PDF | 应用数据、结构化数据 | 坐标排版或原生流式布局 |
| 生成新 PDF | HTML/CSS 页面或模板 | HTML 渲染为 PDF |
| 处理已有 PDF | 可填写的表单(AcroForm) | 表单字段填充 |
| 处理已有 PDF | 可填写的表单(XFA) | XFA 字段处理 |
| 处理已有 PDF | 固定版式加占位文本 | 文本替换 |
前两行从零生成,版面由你的代码或样式表决定;后三行在现成版式上填充,版面已经定死,任务是把值放进它留好的位置。要按月从数据库结果生成一份质量报告,走第一行;前端团队已经维护着 HTML 发票模板,走第二行;拿到供应商的表单,走后三行之一。
本文覆盖的是 Spire.PDF 支持的这些工作流,不是 C# PDF 技术的全量清单。
2. 用代码排版生成 PDF
坐标排版把每段文字、每条线、每张图放在你指定的位置上,适合版式固定的设计稿,也不需要 PDF 库之外的渲染环境。代价在内容长度会变的时候:分页成了你自己的事,要记录上一个元素画到了哪里,自己加页,内容一变还要重算坐标。核心模式如下:
1 | var font = new PdfTrueTypeFont("Segoe UI", 11f, PdfFontStyle.Regular, true); |
关键在跟随排版结果返回的页对象:后续内容画在 r.Page 上,画到底就 Pages.Add() 新页。表格同理需要自己管理跨页,旧版 PdfTable 类(Spire.Pdf.Tables 命名空间)跨页不重复表头。从 DataTable 生成报表有专门教程:C# 在 PDF 文档中创建表格。
原生流式布局把这些从你的代码里拿走了。PdfContentBuilder 从 Spire.PDF for .NET 12.9.18 起可用,按节(Section)组织内容,随内容增长自动分页,支持标题、段落、string[][] 表格、图片、列表、代码块、六种图表、分页符和目录;它只用于创建新文档,没有加载既有文件的入口。
下面这份月度质量报告用两个节和一张表。summaryParagraphs、results(首行为表头的 string[][])和 closing 来自你的业务代码:
1 | using Spire.Pdf; |
内容量是两条路的分水岭。实测中,小报告(两节、五行表)产出 2 页,用时 676 毫秒;更大的报告(八段长文加 40 行表)自动分到 5 页,用时 1,369 毫秒(10.8 KB)。同样的内容用坐标排版画出 3 页,用时 510 毫秒(28.7 KB)。这些数字来自一台 Windows 机器,只作量级参考,比较产出效果比比较速度快慢更有意义。
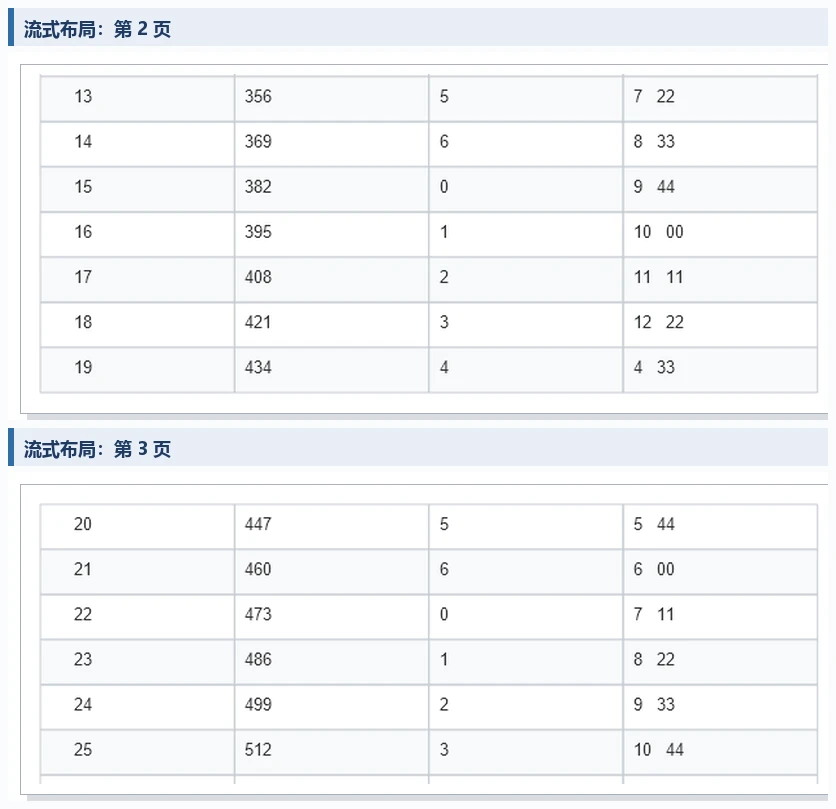
坐标排版适合结构不随数据量变化的页面;流式布局适合长度跟着数据走的文档,比如报告和清单。想把逐元素手绘这条路走深,可以看创建 PDF 文档完整指南。
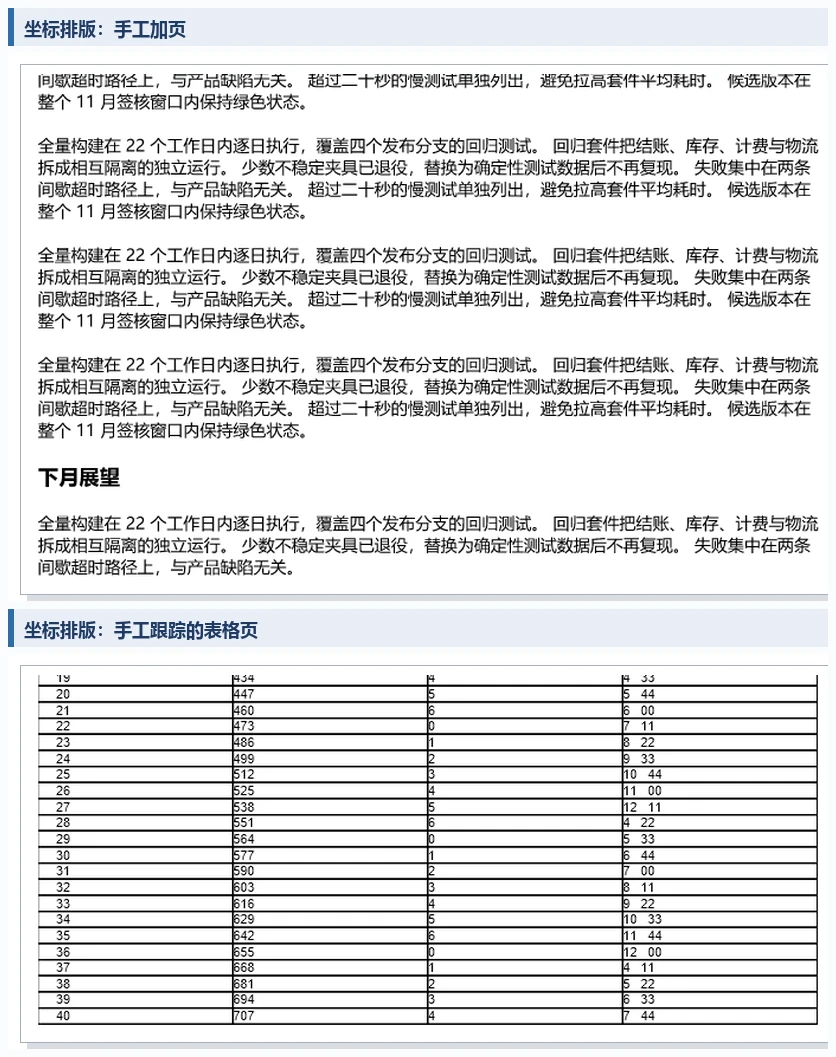
流式布局和 HTML 渲染是两套机制:前者由库自己的内容构建器组织文档,不读 CSS;后者由渲染引擎解析标记和样式表。两者的 API、样式能力与运行环境边界都不同。本文涉及的每条工作流对比如下:
| 工作流 | 布局控制 | 动态内容 | 运行时额外依赖 | 主要限制 |
|---|---|---|---|---|
| 坐标排版 | 精确坐标,逐元素绘制 | 布局与分页由你管理(PdfTextLayout.Paginate) |
无额外渲染引擎 | 内容尺寸一变就要重排坐标 |
原生流式布局(PdfContentBuilder,12.9.18 起) |
节、标题、段落的流式组织 | 流式内容;实测自动分页可用 | 无额外渲染引擎 | 仅用于新建文档;元素覆盖以 API 实际提供为准(表格、图片、列表、代码块、图表、目录) |
| HTML 转 PDF | CSS 加渲染引擎 | 适合 HTML 驱动的内容 | Chromium(Chrome/Edge 路径)或 Qt 渲染插件 | 依赖渲染环境;两个引擎对 CSS 背景的处理不同 |
| AcroForm 填充 | 原表单字段版式 | 按字段名填充 | 无额外渲染引擎 | 受文件里既有字段定义约束 |
| 静态文本替换 | 原页面版式 | 固定文本替换 | 无额外渲染引擎 | 没有通用的动态重排能力 |
3. 把 HTML 渲染成 PDF
要把网页生成 PDF,Spire.PDF 把页面交给渲染引擎,再把打印结果存成文件。有两条引擎可选:ChromeHtmlConverter 驱动 Chromium,传入本机 Chrome 或 Edge 的可执行文件路径;另一条是 Spire.Additions.Qt.HtmlConverter,依赖官方插件包(内含 HTMLConverter.dll、Qt5 运行时与 Html2Pdf.exe),把 plugins 文件夹放到应用程序 exe 同目录即可。缺插件时报错 Fail to load ...\plugins\HTMLConverter.dll : error 126。
同一份 HTML 在两条引擎上都转出了两页,CSS 的 page-break-before 都生效。Qt 引擎用时 4,398 毫秒,产出 60.6 KB,表头的深蓝底色完整保留;Chromium 一侧用 Edge 157.0.4341.42、A4 纸、0.4 英寸页边距,直接复用机器上已有的浏览器。
两条路的取舍:Qt 需要单独装插件,Chromium 复用现成的 Chrome 或 Edge。CSS 背景的打印规则由各引擎自己决定,样式表里可以用 print-color-adjust: exact 这类声明明确要求。Web 应用里建议把转换放进后台任务,而不是卡在请求线程里。
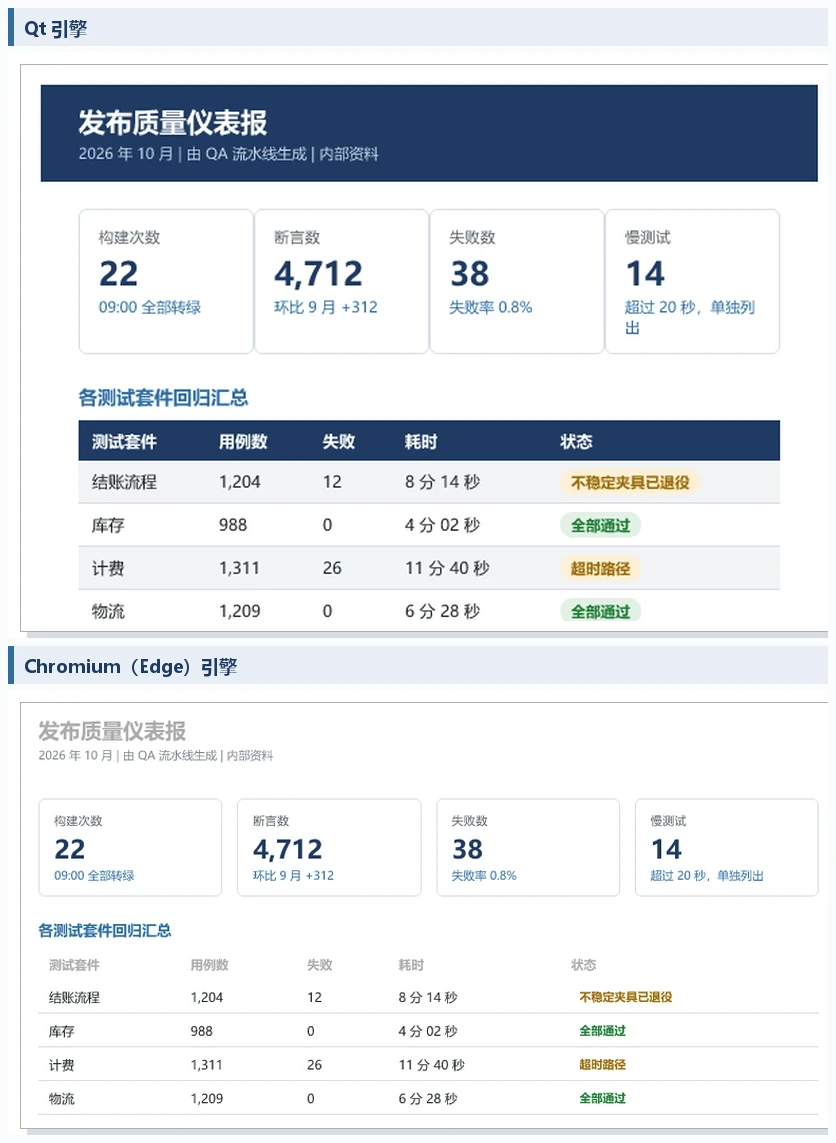
有几点本指南没有覆盖:依赖 JavaScript 才能渲染的页面、外部资源、自定义字体、服务端并发,以及 Linux 或 Docker。开发机能跑不等于生产容器能跑,本指南未验证 Linux。需要从 HTML 模板到数据填充的完整走法,看教程在 C# 中从 HTML 和 PDF 模板生成 PDF。
4. 已有 PDF:表单填充与文本替换
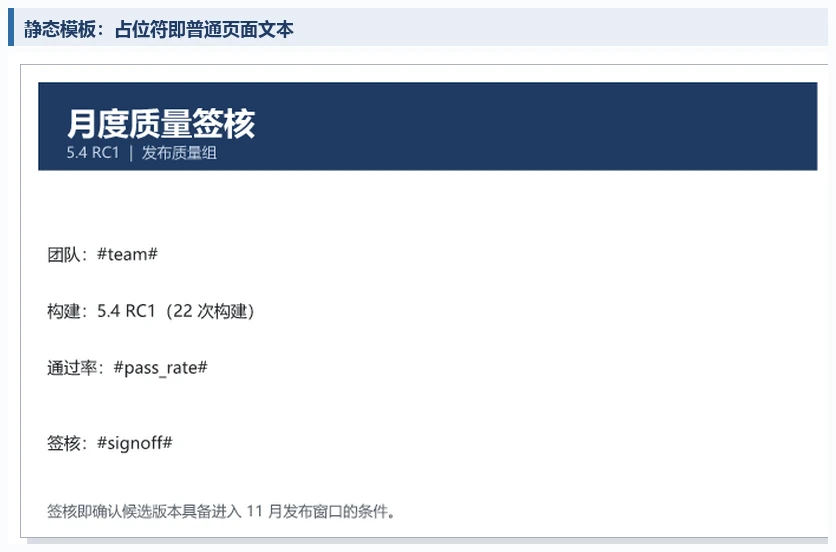
“基于模板生成 PDF”在模板本身是 PDF 的时候指两件不同的事。可填写表单里是带名字的 AcroForm 字段对象;设计稿页面里可能只有看起来像空栏的普通文本。屏幕上几乎一样,代码里完全两回事。
| 对比项 | AcroForm 字段 | 静态占位文本 |
|---|---|---|
| 文件中的存在形式 | 有名字的字段对象 | 普通页面文本 |
| 定位方式 | 字段名 | 文本本身 |
| 交互性 | 展平前保留 | 从不交互 |
| 展平之后 | 值成为页面文本 | 不适用 |
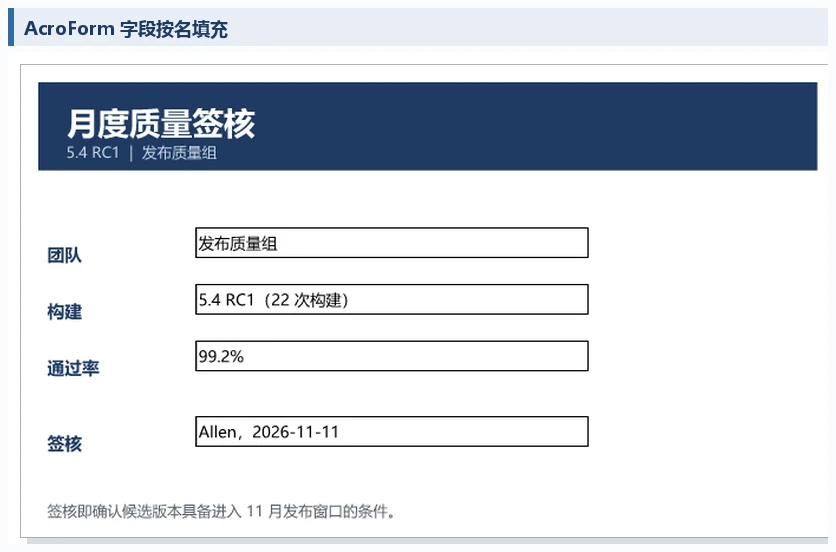
真正的字段按名字定位、赋值、可选展平。Spire.Pdf.Interactive.Forms 命名空间的 AcroForm API 从 12.10.7 引入,本文在 12.11.0 上测试:
1 | using Spire.Pdf.Interactive.Forms; |
实测中有三点值得记住:
- 给
Text赋值后调用RefreshAppearances(),值会立刻画进字段外观。 - 交互状态下的字段值保存在表单层;展平后测试文件的字段数从 4 变成 0,值并入页面文本,
PdfTextExtractor就能读到了。 AddWidget用页面级坐标,page.Canvas的坐标相对页边距,放置控件时两套坐标不要混用。
表单数据也能以 XFDF 导出:form.ExportData(path, DataFormat.XFDF, ...),实测产出了标准 XFDF。更完整的字段操作见教程C# 导入和导出 PDF 表单数据。
固定占位文本适合成品页面:插入的值和被替换的标记长度接近时版面不受影响。替换保留原版式,逐个确认新值放得进原来留出的空间。
XFA 是另一类表单。文档描述的能力是通过 XFA 表单对象读取和修改支持的字段;上线前请用自己的样本验证这条工作流。
5. 部署与结果校验
本指南的测试全部在 Windows 开发机上完成。Linux、Docker 和服务器托管未在验证范围内:Chromium 路线要求目标机器上有浏览器可执行文件,Qt 路线要求 plugins 文件夹跟在应用旁边。Spire.PDF 提供了 Linux 与 macOS 的官方插件包,上生产镜像前请先在自己的部署环境实测,转换耗时也要在目标机器上重新量。
生成类问题很少抛异常:文件总会产出,出了什么问题只能从输出本身看出来。所以校验要看文件,而不是只看代码有没有报错:
| 校验项 | 能发现的问题 | 做法 |
|---|---|---|
| 页数 | 分页多跑、少跑或没翻页 | check.Pages.Count |
| 文本提取 | 标题或数据缺失、占位符残留 | 逐页用 PdfTextExtractor |
| 表单校验 | 值没进到字段里 | 展平前通过 API 读回字段值;展平后重开文件检查可见内容 |
| 目视检查 | 文字溢出、分页错误、字体替换、图片缺失 | 打开 PDF 逐页看 |
1 | PdfDocument check = new PdfDocument(); |
文本提取代替不了目视:它只确认字符在文件里,文字溢出、裁切和背景缺失都看不出来。校验按工作流搭配:坐标与流式输出看页数加目视;HTML 输出重点看背景;表单在展平前用 API 读回字段值。报表类任务建议把前三项放进测试流水线,模板或版式一变就重跑目视检查。每个工作流留一份基准输出,库升级后对比,因为本文每个结论都对应 12.11.0。
6. 常见问题
C# 里”创建 PDF”和”生成 PDF”有区别吗?
API 层面没有。两个词说的都是用代码产出 PDF 文件,真正要分的是输入:应用数据、HTML 页面,还是带字段或占位文本的既有 PDF。按输入选工作流,本文第 1 节的决策表就是按这个划分的。
不引库,纯 C# 能生成 PDF 吗?
技术上可以,PDF 是公开的文件格式,直接往流里写合法。但字体嵌入、流压缩、文本提取支持和跨阅读器的渲染一致性,每一样都要自己实现和测试,这类工作交给成熟的库更省。
代码排版和 HTML 渲染怎么选?
看版面归谁维护。开发自己维护版面、结构由数据决定,用代码画;设计已经沉淀在 HTML 和 CSS 里,交给渲染引擎,同时接受渲染环境的依赖。数据定义页面就写代码,页面定义输出就转 HTML。
7. 结语
应用数据指向坐标排版或原生流式布局,实测中流式布局自己完成了分页;HTML 页面指向渲染引擎,引擎决定了耗时、背景打印和目标机器的依赖;已有 PDF 则按字段和占位文本分两条填充路。产出文件之前,把页数、提取文本和渲染页面这三项检查过一遍。
需要在真实业务环境里评估 Spire.PDF for .NET,可以联系我们申请临时授权。