Python Excel 库对比 2026:4 个主流库实测与选型指南
Python Excel 库对比 2026:4 个主流库实测与选型指南
周一,你需要把 Excel 数据读入 DataFrame 进行分析;周三,客户发来一份工作簿模板,要求在更新内容的同时保留原有图表;周五,财务团队又需要将同一份报表导出为 PDF,并为原始工作簿设置打开密码。Python 中处理 Excel 的库不少,但它们的设计目标和能力边界各不相同。选错工具,问题往往到处理后期才会暴露:保存后图表等对象未能保留、公式单元格缺少可用的计算结果,或者所选库及读取引擎无法处理特定的 .xlsb 文件。
为帮助开发者做出合适的选择,本文围绕一组功能测试文件,并使用同一份 5 万行数据集,对 pandas 3.1.0、openpyxl 3.1.5、XlsxWriter 3.3.1 和 Spire.XLS for Python 16.8.2(商业库)进行了实际测试。测试涵盖文件格式支持、工作簿编辑与对象保留、公式处理与计算、PDF 和 HTML 转换、工作簿加密、读写性能、内存占用、安装要求及授权限制。通过测试结果,可以了解各个库的实际优势与局限,并根据项目需求选择合适的工具。本文仅比较三个开源库和一个商业 SDK,其他商业 SDK 不在讨论范围内。
快速导航
- 如何选择 Python Excel 库
- 开源 Python Excel 库各自擅长什么
- 开源库不够用的五种情况
- Spire.XLS for Python 能做什么
- 构建多步骤的 Excel 处理流程
- 性能、部署、技术支持与版本维护
- Free 版、试用版与商业版的区别
- 结合项目需求选择 Python Excel 库
- 常见问题
- 测试说明
1. 如何选择 Python Excel 库
简单来说:只需读取数据时,pandas 搭配 calamine 引擎速度最快;需要修改已有的 .xlsx 文件时,openpyxl 是最实用的开源方案;需要生成格式化的新报表时,XlsxWriter 是写入速度最快的开源方案。当同一条流程要同时完成多格式读写、公式重算、PDF/HTML 输出和加密等多项工作时,则更适合考虑 Spire.XLS for Python。下表给出概要,具体测试数据见后文各节。
| 库 | 最适合的场景 | 长期使用时需要考虑的问题 |
|---|---|---|
| pandas | 数据分析 | 涉及工作簿级操作时需搭配其他工具 |
| openpyxl | 编辑 XLSX 模板 | 没有内置的公式计算引擎 |
| XlsxWriter | 生成格式化报表 | 无法重新打开已有工作簿 |
| Spire.XLS | 多步骤 Excel 处理 | 商业授权,提供厂商支持与版本更新 |
如果只需要把数据读入 DataFrame,pandas 搭配 calamine 已经足够。若项目后续会走向自动化,可参考 使用 Python 自动写入 Excel。
2. 开源 Python Excel 库各自擅长什么
pandas、openpyxl 和 XlsxWriter 是互补关系,而非相互替代。三者各自在一类任务上表现突出,因此不少项目最终会同时用到其中两三个。
pandas:读取和分析表格数据
pandas 将工作表读取为 DataFrame,这种结构非常适合数据分析。配合 calamine 引擎,可读取 .xlsx、.xlsb、.ods 和 .xls 文件。在本次测试中,该方案的读取速度最快:读取 5 万行 × 6 列数据耗时 294 ms(5 次运行的中位数)。样式方面,可通过 Styler 配合 jinja2 设置,实测单元格的填充和加粗均能正常生效;但在 pandas 3.1 中,数字格式设置未能生效,单元格仍为“常规”格式。
pandas 的边界在于概念本身:DataFrame 不是工作簿。使用 to_excel 写回文件时会重建整个文件,图表、图片和数据透视表不会保留;公式可以写入,但不会计算。读取相关内容可参阅 Python 读取 Excel 文件 和 pandas Excel I/O 官方文档。
openpyxl:编辑已有的 .xlsx 和 .xlsm 文件
openpyxl 可加载工作簿、修改内容并保存。在本次测试的工作簿中,往返保存后图表、图片、条件格式、数据验证、合并单元格、冻结窗格、筛选和数据透视表部件均得以保留,Excel 16.0 打开结果文件时也没有报错。需要说明的是,这一结论仅针对本次测试文件,不代表所有 DrawingML 形状或 VBA 项目都能保留。
openpyxl 的限制比较明确:仅支持 4 种 OOXML 格式(.xlsx、.xlsm、.xltx、.xltm);没有计算引擎,公式不会被计算;无法直接打开受密码保护的文件,需借助 msoffcrypto 等外部工具;数据透视表可以保留,但创建时需通过底层的 add_pivot 手动组装缓存和定义。此外,write_only 模式的内存占用在所有写入方案中最低,仅 79.4 MB。官方文档:openpyxl。
XlsxWriter:生成新报表
XlsxWriter 专用于创建新的 .xlsx 文件,功能完善,支持单元格格式、图表、图片、条件格式、数据验证,以及带缓存值的公式。写入 5 万行数据耗时 1.74 s,是本次测试中速度最快的写入方案,快于 pandas 和 openpyxl 等其他方法。
XlsxWriter 无法读取或修改已有文件,也不支持创建数据透视表、加密,以及输出 .xlsb 或 .ods 格式。官方文档:XlsxWriter。
3. 开源库不够用的五种情况
当任务跨越多个库的专长范围时,单一的开源库就开始力不从心。以下五种情况较为常见。
- 同一流程涉及多种文件格式。 pandas 可以读取 xls、xlsb 和 ods,但读取结果是 DataFrame,编辑后无法以原格式存回;openpyxl 和 XlsxWriter 则完全不支持这些格式。
- 编辑后需要重新计算公式。 openpyxl 会保留公式,但无法求值;pandas 写入的公式不带结果,缓存值取决于底层引擎:使用 openpyxl 时为空值,使用 xlsxwriter 时为占位的 0。Excel 打开文件时会自动重算,但其他读取工具读到的并不是有效结果。
- 数据透视表等复杂对象。 openpyxl 可以保留已有的数据透视表,但没有高层的创建接口;XlsxWriter 和 pandas 则均不提供。
- 输出 PDF、HTML 或图片。 将工作表转换为分页的 PDF 需要额外的库,页面布局、缩放和分页也需自行处理。
- 工作簿密码保护。 三个开源库都无法写出需要密码才能打开的工作簿。
这并不意味着开源库不好。项目规模扩大后,单一用途的工具无法覆盖全部需求,成本也转移到了“胶水代码”上,包括格式转换、库与库之间的文件交接,以及各自独立的依赖升级。每多引入一个工具,就多一套依赖、多一类异常,也多一种文件传递方式。对于同时需要解析 PDF 的文本处理流程,同样适用这一思路,可参考 Python 文档处理。
4. Spire.XLS for Python 能做什么
Spire.XLS for Python 是一款商业库,通过统一的工作簿对象模型完成 Excel 文件的读取、编辑、计算、转换和保护,且无需安装 Microsoft Office。下面结合实际场景介绍各项功能,并说明相应的边界。
读写多种 Excel 格式
LoadFromFile 方法可打开 .xls、.xlsx、.xlsm、.xlsb 和 .ods 文件,SaveToFile 方法可保存为 xlsx、xls、xlsb、xlsm、ods、csv、pdf、html 和 png 格式。加载 CSV 时通过分隔符参数指定,例如 LoadFromFile("data.csv", ",")。典型场景是:上游系统导出 .xlsb 文件,而下游需要 .xlsx 或 PDF。
1 | from spire.xls import * |
兼容性方面有一点需要注意:测试中,Spire.XLS 生成的 .xlsb 和 .ods 文件可被 Excel 16.0 正常打开,但这批文件无法被 pandas 的读取引擎(pyxlsb 和 calamine)读取。因此处理旧格式时,建议使用下游系统实际采用的读取工具做回归测试。
编辑已有工作簿并创建数据透视表
加载工作簿、修改、保存即可。在本次测试的工作簿中,图表、图片、条件格式、数据验证、合并单元格、冻结窗格、筛选和数据透视表在往返保存后均得以保留,Excel 打开文件时也没有报错。对于复杂的 DrawingML 形状,仍建议使用实际文件验证。
创建数据透视表只需两步调用:
1 | sheet = wb.Worksheets[0] |
数据源区域的第一行必须是表头。以上代码仅创建数据透视表的框架,行字段和值字段还需后续配置,具体可参阅 创建和操作数据透视表。测试中,Excel 能够打开生成的文件,并识别出 1 个数据透视表。
重新计算公式并保存缓存值
这里涉及三个概念:公式、缓存结果和重新计算。如果文件中只有公式而没有缓存结果,不具备计算能力的读取工具看到的将是空值。Spire.XLS 内置计算引擎,保存前调用 CalculateAllValue() 即可算出结果,其他工具读取该文件时也能获取到。
1 | wb.LoadFromFile("model.xlsx") |
openpyxl 和 pandas 无法完成这一步;XlsxWriter 可以存储缓存值,但数值需要自行提供。公式语法和单元格级别的示例可参阅 添加或读取 Excel 公式。
将 Excel 转换为 PDF、HTML 和图片
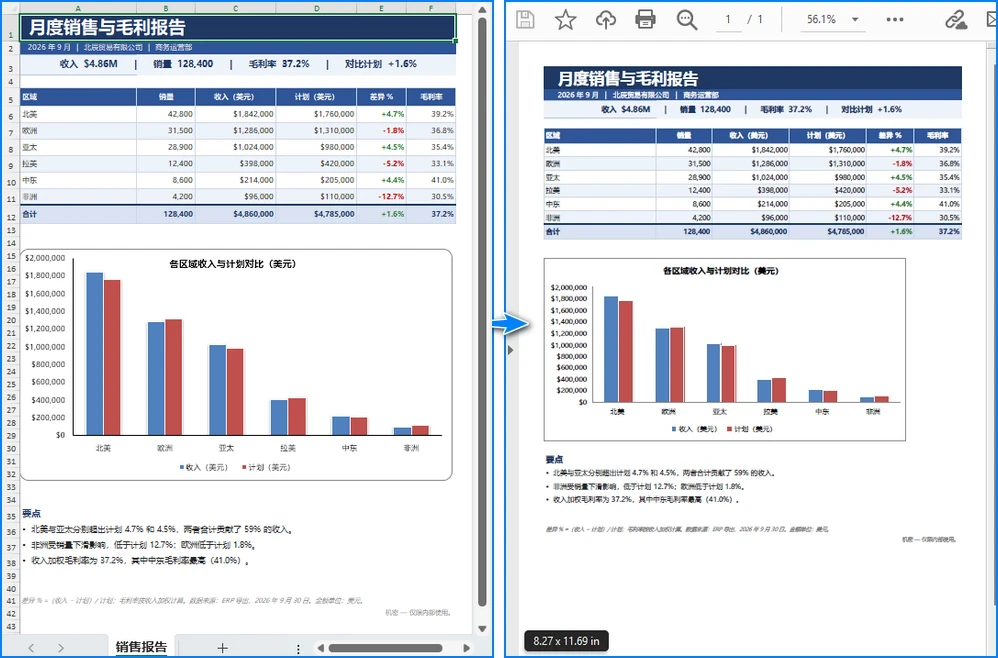
转换为 PDF 前,应先设置页面布局。将页面设为横向并启用适应页面缩放后,测试用的图表可以完整显示在页面内,不会被截断。
1 | sheet = wb.Worksheets[0] |
HTML 输出默认生成框架集(frameset)及一个资源文件夹。将 HTMLOptions.ImageEmbedded 设为 True 后,可输出单个自包含的文件(测试中为 61 KB,内含以 base64 嵌入的 2 张图片)。导出图片可使用 ToImage 方法。页面布局的更多细节可参阅 Python 将 Excel 转换为 PDF。试用版的限制见下文授权部分。
为工作簿设置密码保护
Protect("password") 用于设置打开密码。测试中,保存后的文件成为加密容器,不输入密码就无法打开,而 Spire.XLS 在提供密码的情况下可以重新打开。该功能适用于报表分发和合规场景。工作表锁定等权限级别的保护需另行设置,请参阅官方文档。另外需要注意,在接收两个字符串参数的重载中,SaveToFile 的第二个参数是 CSV 分隔符,而不是密码。
5. 构建多步骤的 Excel 处理流程
以月度报表服务为例,可以较清楚地看出差异。任务流程为:读取上游的 .xlsb 文件,更新其中的输入数据,重新计算公式,生成 PDF,对 Excel 副本加密,最后另存为 .xlsx。
| pandas + openpyxl + 另外 2 个工具 | XlsxWriter | Spire.XLS | |
|---|---|---|---|
| 读取 .xlsb | ✅(仅数据) | ❌ | ✅ |
| 保留工作簿对象 | 否(xlsb 路径下) | ❌ | ✅ |
| 重新计算公式 | ❌ | ❌ | ✅ |
| 导出 PDF | 需额外的库 | 需额外的库 | ✅ |
| 加密 | 需额外的库 | ❌ | ✅ |
| 完成该任务所需的依赖 | 4 个或更多 | 1 个(仅用于写入) | 1 个 |
开源方案可以完成这一任务,但需要分散到至少四个工具上:一个读取二进制格式,一个负责编辑,一个渲染 PDF,一个负责加密;如果还要保留工作簿对象,则另需一个格式转换工具。每次交接,都是一个库写出文件,另一个库再读入。使用 Spire.XLS 时,可以在同一个工作簿对象上完成全部步骤:
1 | from spire.xls import * |
开发与维护成本
本文没有测量节省的时间,也不给出具体数字。能够说明的差异在于复杂度,即任务涉及的步骤、依赖和接口数量。
| 维度 | 开源组合 | Spire.XLS |
|---|---|---|
| 集成 | 工具之间需要交接数据、转换格式 | 统一的工作簿 API |
| 维护 | 需要升级多个组件并保持相互兼容 | 单一的产品版本线 |
| 问题排查 | 问题分散在多个独立项目中 | 统一入口,另有厂商支持 |
| 技术支持 | 社区和 Issue 跟踪 | 官方支持渠道(按授权类型) |
总结起来是一个 Excel 处理库,而不是一个依赖。项目中仍会用到其他包,变化在于 Excel 相关的各个步骤共用同一个对象模型。
动手验证上述流程: 可先使用 Free Spire.XLS for Python 进行 xlsx 读写和小型报表处理,也可使用 Spire.XLS for Python 的试用版评估完整的 API。
6. 性能、部署、技术支持与版本维护
性能基准测试
每项操作均在独立进程中运行,先丢弃 1 次预热结果,再正式运行 5 次,取中位数。数据集为 5 万行 × 6 列,测试环境为 Windows x64 机器(8 个逻辑核心,7.8 GB 内存,Python 3.12)。
| 任务 | 方式 | 中位数 | 峰值内存 |
|---|---|---|---|
| 读取 | pandas(calamine) | 294 ms | 108.2 MB |
| 读取 | Spire.XLS | 1,456 ms | 312.2 MB |
| 读取 | openpyxl read_only |
1,704 ms | 43.9 MB |
| 读取 | pandas(openpyxl 引擎) | 2,177 ms | 91.9 MB |
| 写入 | XlsxWriter | 1,744 ms | 118.8 MB |
| 写入 | pandas → xlsxwriter | 3,477 ms | 118.2 MB |
| 写入 | openpyxl write_only |
3,803 ms | 79.4 MB |
| 写入 | Spire.XLS InsertArray(按列) |
3,987 ms | 325.2 MB |
| 写入 | pandas → openpyxl | 5,205 ms | 173.6 MB |
XlsxWriter 的写入速度最快,pandas 搭配 calamine 的读取速度最快,openpyxl 的 write-only 模式内存占用最低。对原始吞吐量要求较高的场景,这些专用工具仍是更好的选择;Spire.XLS 则适合同一流程需要完成多项 Excel 任务的情况,其读取、写入和内存数据见上表。选择 Spire.XLS 的理由是功能覆盖面,而不是吞吐量。以上数据来自单台机器和单一工作负载,仅供参考,不应视为排名。
部署与兼容性
四个库均不依赖 Microsoft Office。测试机器上安装 Excel 仅用于打开生成的文件进行校验,所有转换过程均未启动 Excel 进程。四个库均可在 Python 3.14.6 上运行。
| pandas | openpyxl | XlsxWriter | Spire.XLS | |
|---|---|---|---|---|
| 安装体积 | 45 MB(另需 numpy 25 MB) | 1.8 MB | 1.6 MB | 70.6 MB |
| 冷启动导入耗时 | 788 ms | 524 ms | 230 ms | 1,027 ms |
Spire.XLS 的安装体积较大,为 70.6 MB,但计入 numpy 后,pandas 方案的体积与之相当。在容器镜像和冷启动场景中,可结合它在多步骤流程中能够替代的包一并权衡。
版本更新与产品维护
Spire.XLS 产品团队确认,产品线按月度节奏发布。就 Python 包而言,PyPI 记录显示 2026 年已有多次常规发布:16.2.0(2 月 5 日)、16.4.0(4 月 8 日)、16.5.0(5 月 7 日)、16.6.0(6 月 18 日)、16.7.1(7 月 17 日)和 16.8.2(8 月 25 日)。根据官方发布说明,16.8.2 版本新增了对 TEXTSPLIT 公式函数的支持,并修复了 OFD 相关问题。Python 包遵循同一发布线,部署前请查看目标版本的发布说明。
技术支持与开发者资源
Spire.XLS for Python 提供 API 文档、代码示例、教程、开发者论坛和邮件支持。商业授权包含 1 年免费更新和技术支持,具体以授权条款为准。响应时间因授权类型而异。根据该产品付费支持页面的说明,Developer OEM、Site 和 Small Business 授权为 48 个工作小时,Site OEM 授权为 24 个工作小时,Gold 和 Platinum 等级提供 24 小时响应及专家支持。购买前请在支持页面确认所持授权的最新条款。
对于生产环境和企业级部署,技术支持本身就是选型标准之一,包括明确的问题升级路径、按授权等级划分的响应目标,以及高等级授权下的优先处理。开源库在这类问题上则依赖社区论坛和 Issue 跟踪。
除 API 覆盖范围外,商业库还意味着一种持续的维护关系。Spire.XLS for Python 保持积极维护,定期发布版本以增加功能并修复已反馈的问题。授权用户按授权条款获得更新和技术支持,更高等级的支持还提供更快的响应目标和优先处理。
7. Free 版、试用版与商业版的区别
Spire.XLS 分为三种版本,限制各不相同,可根据需要验证的内容进行选择。
| 版本 | 版本号 | 限制 | 适用场景 |
|---|---|---|---|
| Free Spire.XLS | 14.12.4 | .xlsx 无限制;.xls 限 5 个工作表、每表 200 行;PDF 限 3 页;无水印 | 验证 xlsx 读写和小型报表 |
| Spire.XLS 试用版 | 16.8.2 | 添加评估警告工作表,PDF 带水印;除图片外的转换仅输出前 10 页 | 评估 API 及 10 页以内的转换 |
| 商业版 | 16.8.2 | 无上述限制(以授权协议为准) | 生产环境 |
在试用版和 Free 版的测试中,xlsx 的读写不受行数或工作表数量限制。根据厂商的限制说明,图片导出不受 10 页限制影响。另有一个实际细节:Free 版保存 .xls 文件后,内存中的工作簿会被截断,因此如需同时保存两种格式,应重新加载源文件。
商业授权包含哪些内容
商业授权在 API 之外,增加了更新与支持服务,具体包括:
- 1 年免费更新
- 1 年免费技术支持
- 因授权类型而异的响应时间
- Gold 和 Platinum 等级的 24 小时响应及专家支持
- 购买前通过邮件和论坛提供的技术咨询
8. 结合项目需求选择 Python Excel 库
可根据流程中需要完成的工作数量,选择合适的库。
- 只读取数据: 使用 pandas 搭配 calamine。
- 只生成新报表: 使用 XlsxWriter。
- 只编辑现有模板: 使用 openpyxl。
- 需要两项以上的高级功能(多种格式、重新计算、转换、加密、数据透视表):可考虑 Spire.XLS,同时还能获得持续的版本发布和厂商支持渠道。
选型时可遵循一条原则:看工作数量,而不是功能数量。 只有一项工作时,选择专用工具;达到两项时,开始考虑集成式的库;一条流程中有三项或更多工作时,集成式库的优势会明显体现。如果处于临界点,建议用实际文件分别在两种方案上测试。同时请注意,保真度结论仅适用于测试所用的文件,复杂对象务必用自己的工作簿验证。
用自己的文件试一试: 下载 Free Spire.XLS for Python 或试用版,并参阅 Spire.XLS for Python 文档,了解上述流程如何对应到实际项目。
9. 常见问题
哪个 Python 库可以在没有 Microsoft Office 的情况下读写 Excel?
本文介绍的四个库均无需安装 Office。pandas(通过 calamine 或 openpyxl)负责读取,XlsxWriter 负责写入,openpyxl 可读写 .xlsx 和 .xlsm,Spire.XLS 则支持读写多种格式。测试中,Excel 仅用于检查输出文件。
pandas 和 openpyxl 有什么区别,该用哪个?
pandas 适合将表格数据加载进来做分析,openpyxl 适合在保留工作簿结构的前提下修改文件。pandas 保存时会重写文件,因此图表、数据透视表等对象不会保留;在本次测试的场景中,openpyxl 则可以保留这些对象。
openpyxl 编辑工作簿时会丢失图表或数据透视表吗?
在本次测试的工作簿中不会:图表、图片、条件格式、数据验证和数据透视表部件均得以保留,Excel 也能正常打开文件。测试文件之外的形状以及 VBA(需要设置 keep_vba=True)均未覆盖,建议使用自己的文件验证。
没有安装 Excel,如何在 Python 中将 Excel 转换为 PDF?
需要使用能自行渲染工作簿的库。以 Spire.XLS 为例,将页面设为横向并设置 FitToPagesWide 和 FitToPagesTall,再以 FileFormat.PDF 保存即可。试用版限制 PDF 输出 10 页,并添加水印。
这些库可以免费用于商业用途吗?
pandas、openpyxl 和 XlsxWriter 是开源库。Spire.XLS 是商业产品,另有 Free 版(xlsx 无限制;.xls 限 5 个工作表、每表 200 行;PDF 限 3 页)和试用版。是否适用于具体项目,请以各库的许可协议为准。
哪个库支持 .xls、.xlsb 和 .ods?
pandas 搭配 calamine 引擎可读取这三种格式。openpyxl 不支持这些格式,XlsxWriter 只能写出 .xlsx。Spire.XLS 可读写 xls、xlsb 和 ods,不过其输出的 xlsb 和 ods 文件,建议使用下游实际采用的读取工具测试。
10. 测试说明
测试于 2026 年 11 月 2 日进行,使用的版本为 pandas 3.1.0、openpyxl 3.1.5、XlsxWriter 3.3.1 和 Spire.XLS for Python 16.8.2(试用版),另使用 Free Spire.XLS 14.12.4 验证版本限制。硬件为 Windows x64(8 个逻辑核心,7.8 GB 内存),运行环境为 Python 3.12.13,并使用 3.14.6 检查兼容性。
功能测试使用的文件是一个包含 3 个工作表、20 行数据的工作簿,其中有公式、图表、图片、条件格式、数据验证、合并单元格、冻结窗格和筛选,另有单独的数据透视表测试文件。性能测试使用 5 万行 × 6 列数据(1.18 MB),先丢弃 1 次预热结果,再正式运行 5 次取中位数,每项操作均在独立进程中执行。Spire.XLS 的批量写入按列进行,因此基准测试中使用 6 次 InsertArray 调用,而不是二维插入。Microsoft Excel 16.0 仅用于打开生成的文件并统计图表和数据透视表的数量。
未覆盖的内容包括:VBA、切片器、Power Query、百万行文件、并发,以及 Linux 和 macOS 环境。基准测试为单机、单一工作负载,测试期间存在 12%–22% 的后台 CPU 占用。维护与支持方面的信息来自官方公开页面和 PyPI 记录,并非本次测试所得。