C# 实现 AI 驱动的文档脱敏:保留原始格式
C# 实现 AI 驱动的文档脱敏:保留原始格式
客户服务、财务、人力资源和法律工作流程中使用的文档通常包含姓名、电子邮件地址、电话号码、家庭住址、账户号码以及其他敏感信息。在共享、归档这些文件或使用它们进行分析之前,可能需要移除或替换其中可识别个人身份的内容。
传统的文档脱敏程序依赖预定义的搜索规则,并且需要针对每种文档格式编写独立的处理逻辑。AI Agent SDK 提供了另一种方式:开发人员可以使用自然语言描述脱敏需求,由智能体识别敏感信息并修改对应的 Office 文档元素。本文将介绍如何使用 C# 对 Word、Excel 和 PowerPoint 文件进行脱敏,同时保留其原始结构和格式。
什么是文档脱敏?
文档脱敏是指移除或替换不应公开的信息。常见的脱敏目标包括:
- 个人姓名
- 电子邮件地址
- 电话和传真号码
- 家庭地址或邮寄地址
- 出生日期
- 客户和员工标识符
- 银行账户和其他账户号码
- 其他机密信息或个人身份信息
对于可编辑的 Office 文件,文档脱敏并不只是修改纯文本。敏感内容可能出现在 Word 段落和表格、Excel 单元格、PowerPoint 形状、页眉、页脚或其他文档元素中。有效的脱敏工作流程应在移除检测到的敏感值时,尽量避免改变周围的布局、样式、图片、图表或文档结构。
使用 C# 对 Office 文档进行脱敏的三种方式
通常有三种实现方式:使用传统文档 API、直接集成 LLM,以及使用 AI Agent SDK。
基于传统 API 的文档脱敏
传统实现通常从精确文本替换或正则表达式开始。例如,Spire.Doc for .NET 提供了用于查找和替换 Word 文档中文本的 API。
下面的简化伪代码展示了基于规则的文档脱敏流程。该示例有意省略了完整实现,只展示应用程序需要处理的主要任务。
1 | Document document = new Document(); |
当敏感信息遵循可预测的格式时,这种方式非常有效。电子邮件地址、电话号码和标准化的身份识别号码通常可以通过正则表达式找到。
当信息需要结合上下文进行判断时,实现难度就会明显增加。程序可能需要判断某个单词是否为人名、某个数字是账户号码还是发票号码,以及某个地点是私人地址还是公开的公司地址。开发人员还需要分别为 Word、Excel 和 PowerPoint 添加不同的遍历与替换逻辑。
直接集成 LLM
与一组正则表达式相比,大语言模型能够更有效地理解上下文。例如,即使姓名没有固定格式,模型也可能从句子中识别出人名。
但是,LLM 本身并不能自动提供完整的 Office 文档处理能力。直接集成通常需要应用程序完成以下工作:
- 从所有相关文档元素中提取文本。
- 将内容拆分为适合发送给模型的请求。
- 将提取的文本发送给模型。
- 将模型返回的结果映射回原始段落、单元格或形状。
- 在不丢失格式的情况下替换敏感内容。
- 以原始格式保存修改后的文件。
如果在发送给模型之前将文档转换为纯文本,有关表格、文本范围、字体、对齐方式以及其他布局属性的信息可能会丢失。因此,开发人员仍然需要负责将模型的语义识别结果与 Office 文档对象模型连接起来。
AI Agent SDK
AI Agent SDK 将自然语言理解与文档处理能力结合在一起。开发人员无需定义每一条检测规则,也不需要手动协调每一个替换步骤,只需提供文档并描述期望的处理结果。
Spire.Agent.Office 使用底层的 Spire.Office for .NET 功能处理 Word、Excel 和 PowerPoint 对象。以 Word 文档为例,处理层可以访问节、段落、文本范围、表格、单元格、页眉、页脚、图片、超链接及其格式。模型负责识别敏感内容,而文档 API 则修改相应的文档元素。
正是这种基于文档对象的处理方式,使程序能够在保留周围文档结构和样式的同时替换文本。
传统 API、LLM 与 AI Agent SDK 对比
| 方式 | 上下文识别 | 格式保留 | 多格式实现 | 开发工作量 | 最适合的场景 |
|---|---|---|---|---|---|
| 传统 API 和正则表达式 | 有限,除非增加额外的 NLP 逻辑 | 可控性强 | 通常需要分别编写处理逻辑 | 高 | 固定格式和要求高度确定性的规则 |
| Office API 与直接调用 LLM | 强 | 需要由开发人员实现 | 每种格式都需要提取和回填逻辑 | 很高 | 完全自定义的 AI 处理流程 |
| AI Agent SDK | 强 | 通过文档感知处理实现 | 可将同一条指令应用于多种 Office 格式 | 较低 | 使用较少编排代码实现上下文感知脱敏 |
当所有脱敏目标都遵循已知格式,并且应用程序需要严格确定的处理结果时,传统方式仍然非常实用。当文档包含多样化且依赖上下文的信息,或者同一工作流程需要支持多种 Office 格式时,AI Agent SDK 更具优势。
配置 C# 项目
创建一个 C# 控制台应用程序,并向项目中添加 Spire.Agent.Office 及其所需依赖项。你还需要一个有效的 SpireToken 才能使用 AI 处理功能。
下面的示例支持以下格式:
- Word:DOC 和 DOCX
- Excel:XLS 和 XLSX
- PowerPoint:PPT 和 PPTX
本示例不包含 PDF。
使用 AI Agent 对 Word、Excel 和 PowerPoint 文档进行脱敏
下面的代码根据源文件的扩展名判断文档格式,加载相应的 Office 文档对象,然后将同一条脱敏指令传递给 AI 处理器。
1 | using Spire.Agent.Office.AI; |
如果项目禁用了隐式全局 using,还需要添加 using System; 和 using System.IO;,以便使用 Array 和 Path。
定义输入、输出和处理指令
inputPath 指定源文档,outputPath 指定脱敏后文件的保存位置。输入文件和输出文件应使用相同的扩展名,以确保结果保持原始格式。
自然语言指令同时定义了检测范围和需要执行的修改。在本示例中,AI Agent 会搜索常见类型的个人信息,并将其替换为 [REDACTED]。
你可以根据更具体的工作流程调整指令。例如:
1 | 查找电子邮箱、电话号码以及客户账号,将所有识别到的敏感内容替换为 “[REDACTED]”。 |
当文档中包含与个人账户号码相似的业务标识符时,在指令中明确排除项可以减少误判。
配置 AI 处理选项
AIOptions 用于保存 AI 处理服务所需的 SpireToken:
1 | AIOptions options = new AIOptions(); |
同一个选项对象可以与 Word、Excel 或 PowerPoint 文档实例一起使用。
选择相应的文档类型
程序读取文件扩展名,并创建相应的对象:
- Word 文件使用
Document - Excel 文件使用
Workbook - PowerPoint 文件使用
Presentation
每个对象都提供 AI() 扩展方法。该方法会返回一个 AIDocumentProcessor,用于对加载的文档执行自然语言指令。
空的附件数组表示该指令不需要任何辅助文件:
1 | processor.ExecuteInstruction( |
脱敏结果
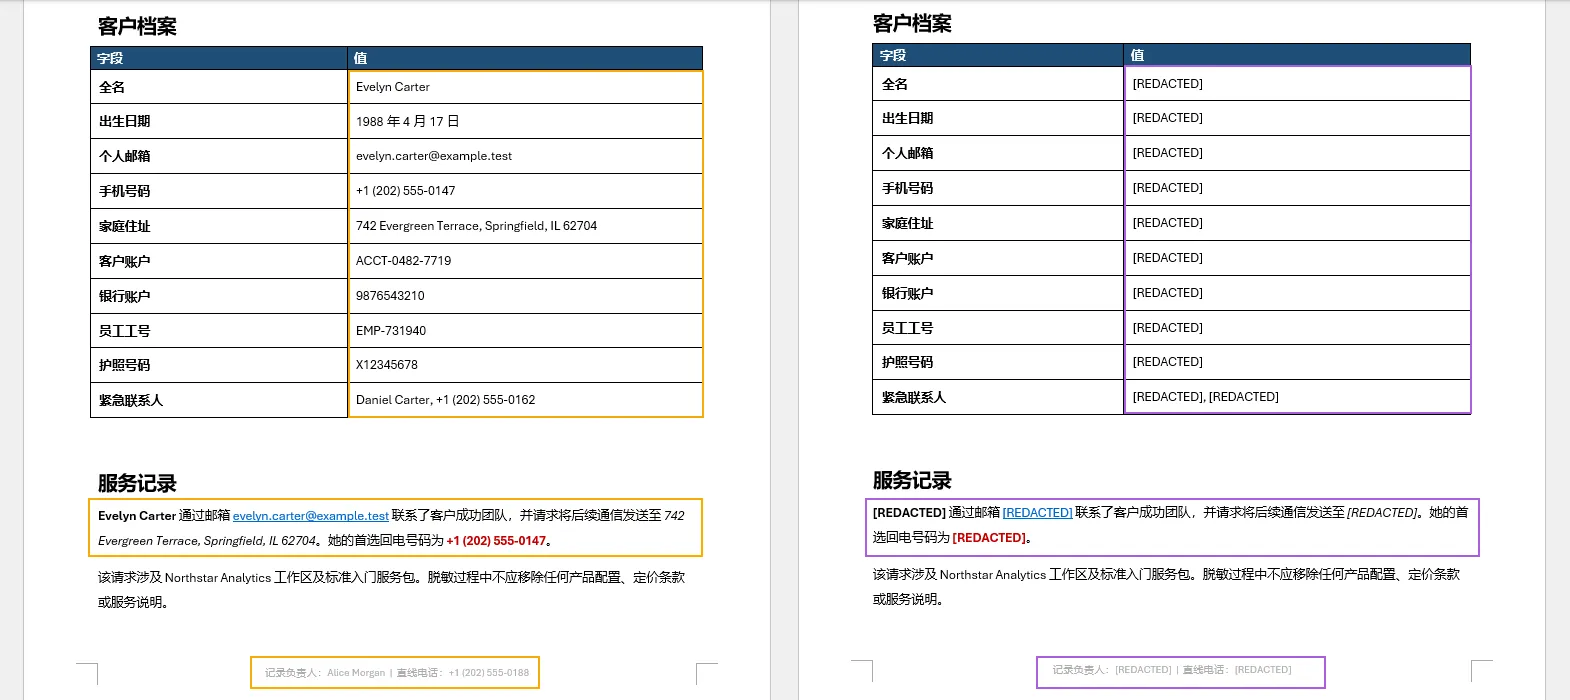
在用于测试的 Word 文档中,敏感信息出现在普通段落、客户信息表格和页面页脚中。处理完成后,姓名、电子邮件地址、电话号码、地址和账户信息均被替换为 [REDACTED]。
表格结构、段落格式、标题、颜色和页脚布局均得到保留。这一结果非常重要,因为它表明该工作流程并不是简单地将文档提取为纯文本后重新构建,而是在保留周围结构的同时修改相关文档元素。
AI 文档脱敏的重要注意事项
分享前检查处理结果
AI 文档脱敏并非完全确定性的处理过程。模型可能漏掉不常见的标识符,也可能错误地将普通内容判断为敏感信息。对于准备对外发布的文档,处理后应进行检查,特别是在法律、金融、医疗或具有合规要求的工作流程中。
提供具体明确的指令
指令应同时说明哪些内容必须移除,以及哪些内容需要保留。如果发票号码、公司名称、产品代码或公开的办公地址不应被脱敏,应在指令中明确说明这些排除项。
替换可见文本不等于彻底清除信息
替换可见文本并不一定能移除文件中保存的每一份信息副本。敏感数据还可能出现在以下位置:
- 批注和修订记录
- 文档属性和元数据
- 隐藏的工作表或幻灯片
- PowerPoint 演讲者备注
- 嵌入的文件和对象
- 包含文字的图片
- 早期版本或备份副本
对于具有较高安全要求的工作流程,应单独检查这些位置。如果文档中包含扫描页面或截图,可能需要先执行 OCR,才能识别图片中的文字。
保留原始文件
将脱敏后的结果保存到新路径,而不是覆盖源文档。分别保留两个文件可以更方便地比较结果、检查遗漏内容,并使用改进后的指令重新执行处理。
总结
基于传统 API 的文档脱敏能够提供精确控制,但开发人员需要自行定义检测规则,并针对不同文档格式和内容容器维护独立的遍历逻辑。直接集成 LLM 可以提升上下文识别能力,但为了保留 Office 文档格式,仍然需要实现大量的文本提取、结果映射和内容回填逻辑。
AI Agent SDK 将这些能力结合在一起。通过一条自然语言指令和少量 C# 代码,同一套工作流程即可处理 Word、Excel 和 PowerPoint 文件,识别与上下文相关的敏感信息,并在原始文档结构中完成替换。处理结果仍然需要检查,但与手动构建完整的检测和文档编排流程相比,其实现方式明显更加简单。
常见问题
同一段代码可以对 Word、Excel 和 PowerPoint 文件进行脱敏吗?
可以。示例根据输入文件的扩展名选择 Document、Workbook 或 Presentation,然后将同一条自然语言指令应用于相应的文档格式。
AI Agent 能否保留原始格式?
AI Agent 使用底层的 Office 文档对象处理内容,因此可以在段落、单元格、表格和形状中替换敏感文本,同时保留周围的结构和格式。由于特别复杂的布局可能仍需要进一步验证,因此应对最终输出进行检查。
可以使用其他脱敏标记吗?
可以。将指令中的 [REDACTED] 更改为其他标记,例如 [私有信息]、[已删除],或者 [邮件已脱敏] 这类用于特定信息类别的标记。
什么时候传统 API 比 AI 文档脱敏更合适?
当所有敏感信息都遵循固定格式、处理规则很少变化,并且结果必须完全确定时,传统 API 可能更加合适。对于标准化的电子邮件地址、电话号码或身份识别号码,使用正则表达式进行替换通常已经足够。
替换文本是否能够保证文档可以安全发布?
不能。替换可见文本并不会自动删除批注、修订记录、元数据、隐藏内容、嵌入对象、图片中的文字或文件的历史版本。对于具有安全要求的文档,在发布前还需要进行额外检查和验证。